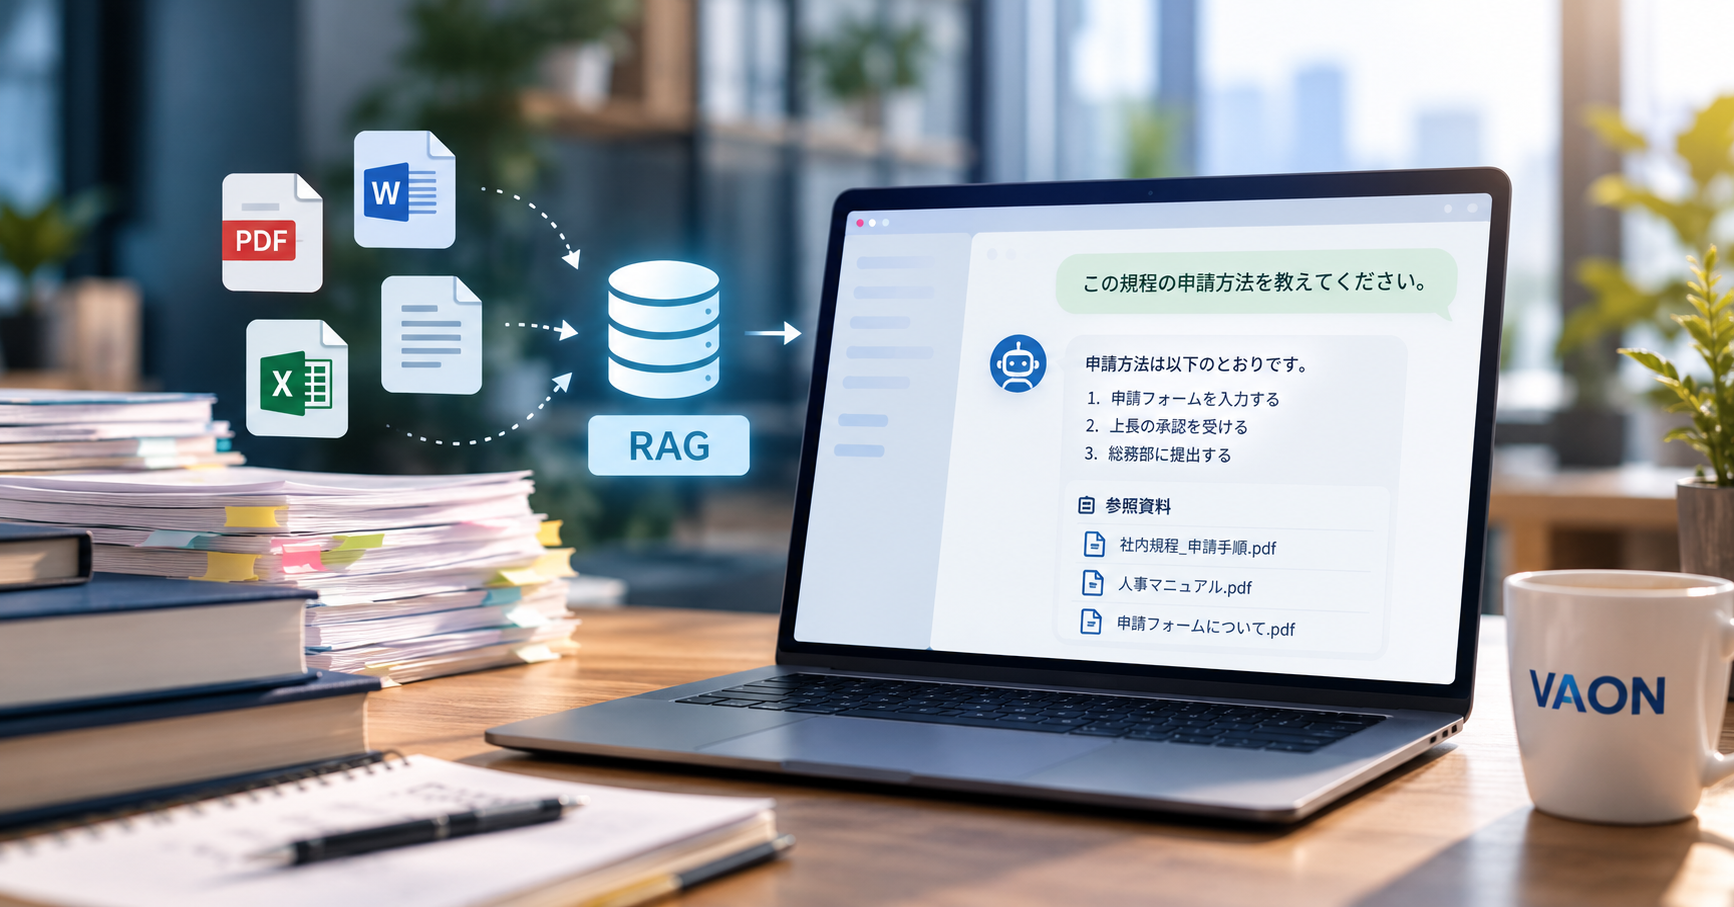
要約: RAGチャットボットがPoC(試験導入)で止まりやすいのは、どれくらい正しいのかを誰も数字で言えないためです。本番に進むには、資料の整理、適切な分割、実際の質問と正解で作る評価セット、「分からない」と答える設計、権限管理、公開後の改善サイクルが必要です。
目次
- RAGチャットボットは、なぜデモでは良くてもPoCで止まるのか
- RAGの精度は、どの段階で崩れるのか
- 資料は、取り込む前に何を整えるべきか
- 評価セットは、どう作ればよいか
- 答えが分からないとき、チャットボットはどうすべきか
- 公開後の運用サイクルは、どう回すのか
- 本番に進めるべきでないのは、どんな場合か
1. RAGチャットボットは、なぜデモでは良くてもPoCで止まるのか
RAG(関連する資料の箇所を検索し、それをもとにAIが回答を作る仕組み)のチャットボットがPoCで止まるのは、デモでは事前に選んだ数問しか使わないのに対し、実際の利用者は誰も想定していなかった質問をするからです。社員が使い始めると、誤った回答がいくつか表に出ます。そこで「どれくらい正しいのか」と聞かれても、誰も答えられません。
数字がなければ、審査する側には承認する根拠がありません。担当者は、誤答を1件ずつ感覚で直すしかなく、直したことで別の回答が悪くなっていないかも分かりません。そのまま数か月が過ぎ、案件は立ち消えになりがちです。
最初にすべきことは、多くの場合AIモデルの入れ替えではありません。物差しを決め、実際に悪い段階を直すことです。
2. RAGの精度は、どの段階で崩れるのか
RAGの精度が崩れるのは、検索が違う箇所を拾う場合と、正しい箇所を拾ってもAIの言い回しが誤る場合のどちらかです。直し方が異なるため、何かを調整する前に、どちらなのかを切り分ける必要があります。
| 症状 | よくある原因 | 対応の方向 |
|---|---|---|
| 違う資料や古い版から回答する | 同じ資料の複数の版が混在している。有効日がない | 資料を整理し、版と有効日を付ける |
| 資料にあるはずの箇所が見つからない | 分割が内容の途中で切れている。質問の言葉が資料と違う | 構造に沿って分割し、キーワード検索と意味検索を併用する |
| 表や帳票の数字が違う | 画像のみのPDF。読み取り時に表が崩れる | 表を構造化した形に変換してから取り込む |
| 箇所は正しいのに回答が違う | 箇所が途中で切れている。複数の箇所を組み合わせる質問 | 分割をやり直し、AIが推測してよい範囲を絞る |
| 資料にないことを自信ありげに答える | 「分からない」と答える規則がない | しきい値と断り方を設計する(5章) |
この表から分かるように、症状の多くは資料と検索に起因します。プロンプトの調整で対応できるのは、残りの部分です。
3. 資料は、取り込む前に何を整えるべきか
RAGチャットボットは、読ませた資料以上には賢くなれないため、取り込む前に資料を選び、整理し、情報を付ける必要があります。PoCの納期に合わせてこの工程を削ると、質の悪い資料を読むチャットボットができあがります。
- 元になる資料を選ぶ。 1つのテーマにつき、正とする資料を1つに絞ります。草稿、旧版、メールで転送されたコピーは除きます。
- 読み取りにくい形式を確認する。 スキャンしたPDF、セルを結合した表、画像の中の文字、図だけのスライドは誤って読まれがちです。種類ごとに開いて、システムが実際に何を読み取るかを確かめます。
- 意味のまとまりで分割する(チャンク分割)。 文字数で一律に切るより、見出しや条文で分けるほうが、多くの場合うまくいきます。条文を途中で切ると、半分だけ正しい箇所ができます。
- 付随情報を付ける。 版、有効日、部署、機密レベルです。古い資料を除くのに役立ち、権限管理の土台にもなります。
- 資料の責任者を決める。 規程が変わったとき、誰が更新するのか。名前がなければ、チャットボットは失効した規程で回答します。
5番は最も見落とされやすく、公開時は正しかったチャットボットが数か月後に誤り始める理由でもあります。
4. 評価セットは、どう作ればよいか
評価セットは、利用者の実際の質問を50〜100問集め、それぞれに業務担当者が確認した正解と根拠資料を付けて作ります。VAONがPoCでお勧めしている方法で、「問題なさそう」という印象を、承認できる数字に変えるためです。
作り方は次のとおりです。
- 質問は現場から集める。 社内の問い合わせメール、コールセンターの履歴、総務や人事へよく来る質問です。プロジェクトチームが考えると、資料の書き方に沿った質問になってしまいます。
- 種類を混ぜる。 1つの事実を調べる質問、2つの資料をまたぐ質問、資料と違う言い回しの質問、資料に答えがない質問を含めます。
- 正解は業務担当者が書く。 技術担当者ではありません。
- 合格基準は実行前に決める。 たとえば、正答率がどの水準なら本番へ進むか。数値はお客様とVAONで合意します。すべての案件に共通する基準はありません。
測定では、3つの指標を分けます。検索が正しい箇所を拾えたか、回答は正しいか、答えのない質問で正しく断れたか、です。分けて見ることで、資料を直すべきか、回答の仕方を直すべきかが分かります。
結果の示し方の例。 VAONは、日本のWebサービス会社(匿名)向けに、AIによる文書処理の自動化案件を行いました。手作業は20〜35%減り、精度は85〜92%でした。これは文書処理の案件であり、RAGチャットボットではないため、チャットボットの目安にはなりません。参考にしていただきたいのは、示し方です。特定のデータに対する幅のある結果として示しており、すべての場合に通用する1つの数字としては示していません。御社のチャットボットも、同じ形で報告するのがよいでしょう。
5. 答えが分からないとき、チャットボットはどうすべきか
RAGチャットボットは、推測で答えるのではなく、見つからなかったと伝えたうえで、相談先の担当者や資料を案内すべきです。「見つかりませんでした。人事部にお問い合わせください」という返答は、自信ありげな誤答よりもはるかに害が小さいからです。
そのためには、最初から次の設計が必要です。
- しきい値を決める。見つかった箇所の関連度が足りないときは、答えずに断ります。
- 根拠を表示する。回答ごとに、使った資料と箇所を示し、利用者が確認できるようにします。
- 人への引き継ぎ先を示す。断る返答に、次の問い合わせ先を添えます。
- 「答えのない質問」を評価セットに入れる。適切に断れるかどうかも測るためです。
権限管理もここに含まれます。チャットボットは、質問者が閲覧を許されている資料だけを検索するべきで、絞り込みは画面だけでなく検索の段階で行う必要があります。回答が正しくても、見せてはいけない人に社内資料を見せるチャットボットは使えません。隠された指示を含む資料が紛れ込むリスクは別の問題で、プロンプトインジェクションとRAGへの攻撃で扱っています。チャットボットサービスのデータの扱いについては、RAGと学習の違い、契約で確認することをご覧ください。
6. 公開後の運用サイクルは、どう回すのか
公開後の運用は、実際の質問を集める、誤答や断った回答を見直す、資料や検索を直す、評価セットを再実行する、の4つを繰り返します。このサイクルがないと、資料が変わるにつれて精度は少しずつ落ちていきます。
- 集める。 利用者の実際の質問と、「役に立った/立たなかった」の評価を記録します。
- 見直す。 週次または月次で、業務担当者が低評価の回答と断った回答を読みます。
- 原因の箇所を直す。 資料がなければ追加し、古ければ差し替え、分割が悪ければやり直します。モデルの変更は、多くの場合最後の手段です。
- 測り直す。 新しい質問を評価セットに加え、全体を再実行して、1つの修正が別の回答を悪くしていないか確認します。
実際の質問は、最も価値のあるデータです。数回繰り返すと、評価セットはPoCの時に作ったものより、御社の利用者をよく反映するようになります。
7. 本番に進めるべきでないのは、どんな場合か
元の資料が安定していない、責任者がいない、あるいは誤答が結果に響くのに確認する人がいない場合は、RAGチャットボットを本番に進めるべきではありません。その場合、最初にすべきことはチャットボットではなく資料の修正です。
特に慎重を要するのは、法的な条文、医療に関する内容、金額に直結する判断に関わる回答です。RAGは作り話を減らしますが、なくすわけではないため、こうした内容は利用者に届く前に人が確認する必要があります。データを社内ネットワークの外に出せない場合は、別の構成を検討します。閉域網・社内ネットワークで動くRAGチャットボットをご覧ください。VAONのAI関連のサービスは、AI・自動化のサービスページにまとめています。
RAGチャットボットがPoCで止まっていて、どこから直すべきか迷っていませんか。 実際の質問を数十問と、サンプルの資料をお持ちください。初回のご相談には、VAONの代表が同席します。ご契約の義務はありません。無料相談(60分)
参考資料
- Lewis, P. et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020: https://arxiv.org/abs/2005.11401