CNNがコンピュータビジョンを席巻した時代
コンピュータに写真の中の「猫」を認識させたいと想像してみてください。
ディープラーニングが普及する前、コンピュータビジョンシステムはエッジ、コーナー、テクスチャ、あるいはSIFTやHOGといった人間が手作業で設計した特徴量(ハンドクラフト特徴量)に頼っていました。
CNN(Convolutional Neural Network:畳み込みニューラルネットワーク)が、その状況を一変させました。
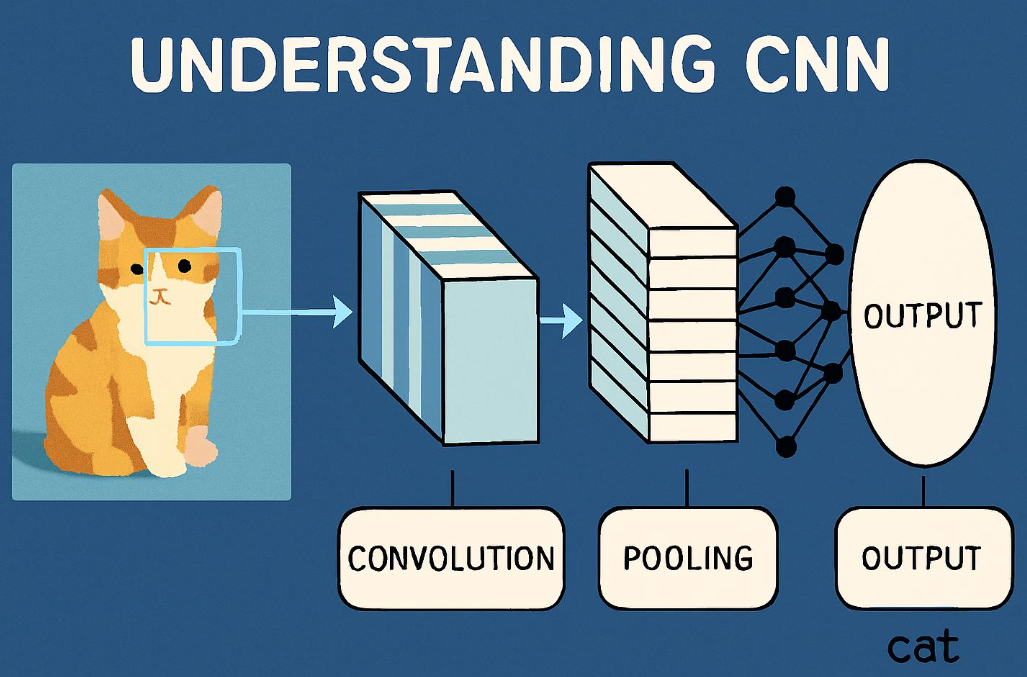
どの特徴を探すべきかを人間が指示する代わりに、CNNは学習プロセスを通じてデータから有用な特徴を自動的に獲得できるようになったのです。
LeNetからAlexNet、VGG、そしてResNetへと進化するにつれ、CNNは画像分類(Image Classification)、物体検出(Object Detection)、セマンティックセグメンテーション(Semantic Segmentation)など、数多くのタスクの基盤となりました。
CNNの成功の核心は、畳み込み演算(Convolution)にあります。
小さなカーネル(フィルタ)が画像上をスライドしながら、局所的な特徴を抽出します。そして複数の層を経ることで、モデルは単純な特徴を組み合わせて、より複雑な表現へと昇華させます。
例えば、浅い層ではエッジや線を学習し、深い層ではそれらを組み合わせてパーツや形状、さらには物体認識に役立つ高度な表現を学習します。
画像には「近くにあるピクセル同士は強い関係を持つ」という空間的構造があるため、このアプローチは極めて効果的でした。
しかし、ここで一つの興味深い疑問が浮かび上がります。
もしモデルが、同じ画像内の「遠く離れた領域間の関係」を理解する必要がある場合はどうなるでしょうか?
CNNでも、多くの層を重ねることでそうした長距離の依存関係を学習することは可能です。しかし、より直接的なアプローチはないのでしょうか?
Vision Transformer:画像をトークンの列として扱う
2017年、論文『Attention Is All You Need』によって、自然言語処理(NLP)の分野にTransformerが登場しました。
そして2020年、Googleの研究チームが『An Image Is Worth 16x16 Words』を発表し、Vision Transformer(ViT)を世に送り出しました。

そのアイデアは非常にユニークです。
「Transformerが単語の列(シーケンス)を処理できるなら、画像を小さなパッチの列に変換してしまえばいいのではないか?」
畳み込みフィルタを主体として画像を処理する代わりに、ViTは画像を小さなパッチに分割します。
例えば、224 × 224ピクセルの画像を、16 × 16ピクセルのパッチ196個に分割します。
各パッチは埋め込みベクトル(Embedding)に変換され、位置情報(Positional Embedding)と結合された上で、Transformer Encoderに入力されます。
ここでSelf-Attention(自己注意機構)が働き、画像内でどれだけ離れているかに関係なく、パッチ間の情報を直接統合できるようになります。
これこそが決定的な違いです。
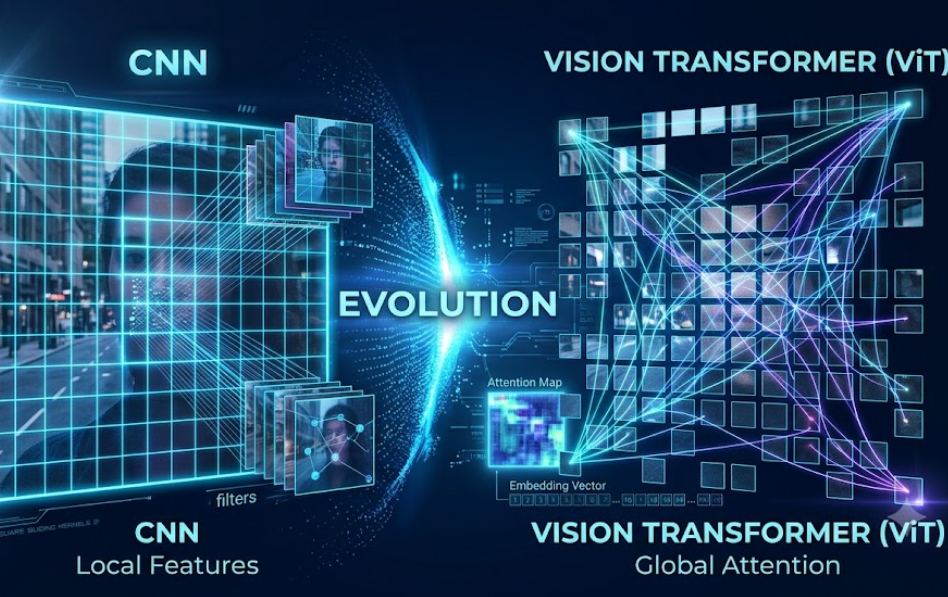
- CNNは畳み込みを通じて局所的な構造を捉え、深い層へと進むにつれて徐々に情報を統合します。
- ViTはAttentionを用いてパッチ間の関係をモデル化し、グローバルなAttention層でパッチ同士を直接相互作用させます。
ViTは、特に大規模なデータセットで事前学習(Pre-training)された場合において、画像認識に強力な新しいアプローチを切り拓きました。
しかし、弱点がないわけではありません。
ViTは本当にCNNより優れているのか?
Vision Transformerの躍進により、多くの人が「CNNはもう時代遅れなのか?」と疑問を抱くようになりました。
答えはそう単純ではありません。
CNNは画像処理向けに非常に「賢い」設計(帰納的バイアス)を持っています。隣接するピクセルをまとめて細部を理解し、同じフィルタを画像全体で再利用します。そのおかげで、データが少ない場合や計算リソースが限られている環境でも、非常に効率よく高速に学習できます。
一方、標準的なViTは画像を「白紙の状態」から捉えるため、空間的なルールをゼロから手探りで学習しなければなりません。何百万枚もの画像で事前学習させると圧倒的な強さを発揮しますが、データが少ない場合や、高解像度画像が細かなパッチに分割されすぎた場合には苦戦しやすくなります。
そして2022年、ConvNeXtが登場しました。伝統的なCNNアーキテクチャをベースにしつつ、Transformerにヒントを得た最新の設計と学習手法を取り入れたConvNeXtは、多くのベンチマークでViTと互角以上に渡り合えることを証明しました。
つまり、この競争は単なる「畳み込み(Convolution)対 自己注意機構(Self-Attention)」の戦いではなかったのです。モデルの設計、データの規模、そして学習手法こそが、最終的な性能を左右する決定的な要素だったのです。
では、CNNとViTのどちらを選ぶべきか?
例えば、ユニフォームがよく似ている2つの配送会社の配達員を見分けるシステムを作るとしましょう。
単純なモデルは服の色だけを学習してしまうかもしれませんが、実際にブランドを見分けるための決定打となる特徴は、ロゴや模様、あるいはごく小さなディテールにあります。
このような実務の場面では、問題は単に「CNNかViTか」を選ぶことではありません。
データの品質、対象物のクロップ方法、画像の解像度、特徴量の学習能力、そして実データにおけるモデルの評価方法に目を向ける必要があります。
適切にファインチューニングされたCNNで十分な場合もあれば、事前学習済みのVision Transformerから抽出したEmbedding(埋め込み表現)を使った方が良い結果を得られる場合もあります。
答えは「どちらのアーキテクチャが新しいか」ではなく、実験と検証(エンピリカルなアプローチ)から導き出されるべきです。
結論
コンピュータビジョンの発展を振り返ると、各世代のモデルが「視覚情報をどのように学習・表現するか」というパラダイムを塗り替えてきたことがわかります。
CNNは空間的構造を活用する力を証明しました。Vision TransformerはSelf-Attentionによって画像領域間のグローバルな関係を学習する能力を拡張しました。そして現在のVision Foundation Models(視覚基盤モデル)は、再利用可能な汎用視覚表現の構築という目標にさらに近づいています。
ViTの登場によってCNNが死んだわけではありません。コンピュータビジョンは、複雑な課題を解決するための「より優れた選択肢」を増やしているのです。
結局のところ、最良のアーキテクチャとは最新のアーキテクチャではなく、手元のデータ、計算リソース、そして解決すべき課題に最も適したアーキテクチャなのです。