Khi CNN thống trị Computer Vision
Hãy tưởng tượng chúng ta muốn dạy máy tính nhận ra một con mèo trong bức ảnh.
Trước khi Deep Learning trở nên phổ biến, các hệ thống Computer Vision thường phải dựa vào những đặc trưng được thiết kế thủ công như cạnh, góc, kết cấu hay SIFT, HOG.
CNN (Convolutional Neural Network) đã thay đổi điều đó.
Thay vì phải chỉ cho máy tính những đặc trưng nào cần tìm, CNN có thể tự học các đặc trưng hữu ích từ dữ liệu trong quá trình huấn luyện.
Từ LeNet đến AlexNet, VGG và ResNet, CNN dần trở thành nền tảng cho hàng loạt bài toán như Image Classification, Object Detection và Semantic Segmentation.
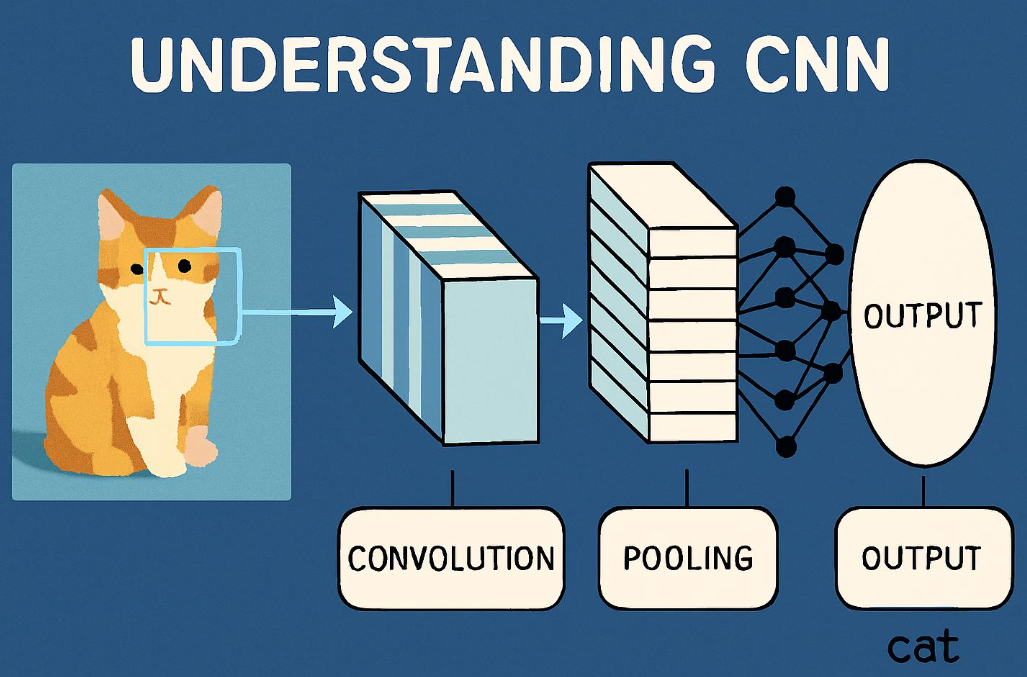
Điểm cốt lõi giúp CNN thành công nằm ở phép tích chập (convolution).
Một kernel nhỏ di chuyển trên bức ảnh để trích xuất các đặc trưng cục bộ. Qua nhiều tầng, mô hình có thể kết hợp những đặc trưng đơn giản thành biểu diễn phức tạp hơn.
Chẳng hạn, các tầng đầu có thể học cạnh và đường nét; những tầng sâu hơn kết hợp chúng thành các bộ phận, hình dạng và những biểu diễn phục vụ nhận diện đối tượng.
Cách làm này cực kỳ hiệu quả vì hình ảnh có cấu trúc không gian: các pixel nằm gần nhau thường có quan hệ với nhau.
Nhưng cũng từ đây xuất hiện một câu hỏi thú vị.
Điều gì xảy ra nếu mô hình cần hiểu mối quan hệ giữa những vùng nằm rất xa nhau trong cùng bức ảnh?
CNN vẫn có thể học được những quan hệ đó thông qua nhiều tầng xử lý. Tuy nhiên, liệu có cách tiếp cận trực tiếp hơn?
Vision Transformer: Khi hình ảnh được xử lý như một chuỗi token
Năm 2017, Transformer xuất hiện trong lĩnh vực Natural Language Processing với bài báo Attention Is All You Need.
Đến năm 2020, một nhóm nghiên cứu tại Google công bố An Image Is Worth 16x16 Words, giới thiệu Vision Transformer (ViT).
Ý tưởng rất thú vị:
Nếu Transformer có thể xử lý một chuỗi từ, tại sao chúng ta không biến hình ảnh thành một chuỗi các patch?

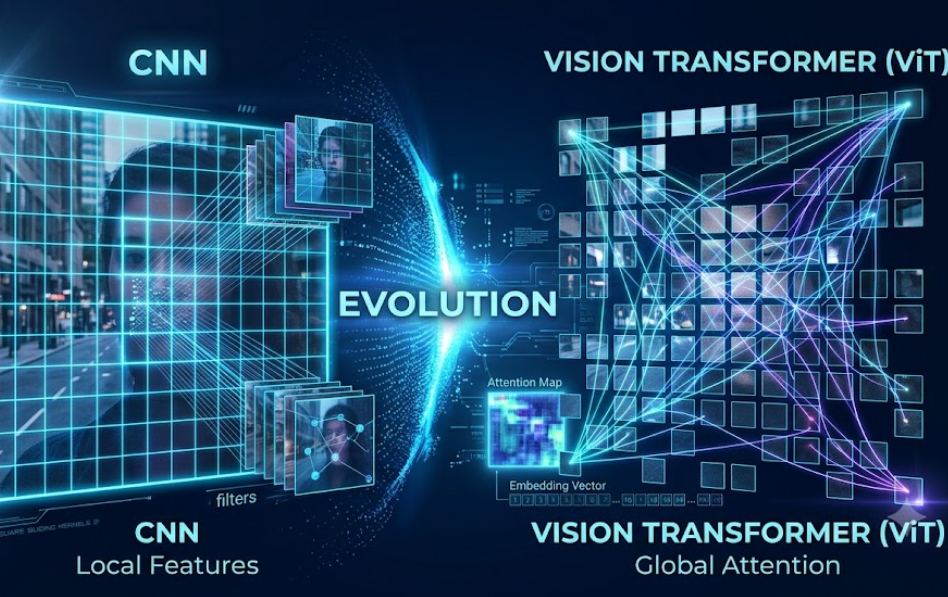
Thay vì xử lý ảnh chủ yếu thông qua các bộ lọc convolution, ViT chia ảnh thành những patch nhỏ.
Ví dụ, ảnh 224 × 224 pixel được chia thành 196 patch có kích thước 16 × 16 pixel.
Mỗi patch được chuyển thành một vector embedding, kết hợp với thông tin vị trí rồi đưa vào Transformer Encoder.
Tại đây, cơ chế Self-Attention cho phép mô hình kết hợp thông tin giữa các patch, kể cả khi chúng nằm cách xa nhau trong bức ảnh.
Đây là điểm khác biệt quan trọng.
- CNN khai thác cấu trúc cục bộ thông qua convolution và dần tổng hợp thông tin ở các tầng sâu.
- ViT sử dụng attention để mô hình hóa quan hệ giữa các patch, cho phép chúng tương tác trực tiếp trong các lớp attention toàn cục.
ViT mở ra một hướng tiếp cận rất mạnh cho Image Recognition, đặc biệt khi được pretrained trên lượng dữ liệu lớn.
Tuy nhiên, nó không phải không có điểm yếu.
Liệu ViT có thực sự tốt hơn CNN?
Sự thành công của Vision Transformer khiến nhiều người đặt câu hỏi: CNN có đang trở nên lỗi thời?
Câu trả lời không đơn giản như vậy.
CNN được thiết kế rất "khôn" cho việc xử lý ảnh: nó biết gom các điểm ảnh nằm cạnh nhau để hiểu chi tiết và dùng lại một bộ lọc để quét khắp bức ảnh. Nhờ vậy, CNN học cực nhanh ngay cả khi có ít dữ liệu hoặc máy cấu hình yếu.
Ngược lại, ViT nguyên bản tiếp cận bức ảnh như một tờ giấy trắng và phải tự mò mẫm quy luật từ con số 0. Nó cực mạnh khi được "nhồi" hàng triệu bức ảnh để học trước, nhưng lại dễ đuối sức nếu dữ liệu ít hoặc ảnh bị chia thành quá nhiều mảnh.
Đến năm 2022, mô hình ConvNeXt ra đời. Vẫn dùng kiến trúc CNN truyền thống nhưng được nâng cấp cách thiết kế và huấn luyện hiện đại, ConvNeXt chứng minh CNN vẫn đủ sức cạnh tranh sòng phẳng với ViT trên nhiều bảng xếp hạng.
Hóa ra, cuộc đua không chỉ là phép tích chập (Convolution) đối đầu với cơ chế tự chú ý (Self-Attention). Chính cách thiết kế mô hình, dữ liệu và phương pháp huấn luyện mới là yếu tố quyết định.
Vậy nên chọn CNN hay ViT?
Giả sử chúng ta cần phân biệt hai hãng giao hàng có đồng phục gần giống nhau.
Một mô hình có thể học màu áo, trong khi những đặc trưng thực sự giúp phân biệt thương hiệu lại là logo, họa tiết hay những chi tiết rất nhỏ.
Lúc này, vấn đề không chỉ là chọn CNN hay ViT.
Chúng ta phải quan tâm đến chất lượng dữ liệu, cách crop đối tượng, độ phân giải ảnh, khả năng học đặc trưng và cách đánh giá mô hình trên dữ liệu thực tế.
Có thể một CNN được fine-tune tốt đã đủ. Cũng có thể embeddings từ một Vision Transformer pretrained mang lại kết quả tốt hơn.
Câu trả lời nên đến từ thực nghiệm, không phải từ việc kiến trúc nào mới hơn.
Kết luận
Nhìn lại hành trình phát triển của Computer Vision, có thể thấy mỗi thế hệ mô hình đều giúp chúng ta thay đổi cách học và biểu diễn thông tin hình ảnh.
CNN chứng minh sức mạnh của việc khai thác cấu trúc không gian. Vision Transformer mở rộng khả năng học quan hệ giữa các vùng ảnh bằng Self-Attention. Vision Foundation Models tiếp tục đưa lĩnh vực này đến gần hơn với mục tiêu xây dựng những biểu diễn thị giác có thể tái sử dụng.
CNN không chết khi ViT xuất hiện. Computer Vision chỉ đang có thêm những cách tốt hơn để giải quyết những bài toán phức tạp.
Và cuối cùng, kiến trúc tốt nhất không nhất thiết là kiến trúc mới nhất, mà là kiến trúc phù hợp với dữ liệu, tài nguyên và bài toán chúng ta cần giải quyết.