Beszelによるサーバー監視:VAONがGrafanaから移行した理由
要約: Beszelは、ハブと各サーバーで動くエージェントで構成されるオープンソースのサーバー監視ツールです。VAONは、指標は多いものの日常的に見られていなかったGrafanaから、社内サーバーの監視をBeszelへ移行しました。全サーバーを1画面で確認でき、Dockerの指標、アラート、S.M.A.R.T.にも標準で対応します。一方、ログは確認できません。

Grafanaの運用で、何が課題になっていたのか
課題はGrafanaそのものではなく、VAONの開発チームが以前のプロダクトでどう使っていたかにありました。Grafanaはほぼあらゆる指標を収集でき、ダッシュボードも自由に作れます。そのため、プロジェクトが増えるたびに画面も増えていきました。
運用を続けるうちに、次の3つの課題が出てきました。
- プロジェクトごとにダッシュボードがあり、同じ指標が少しずつ異なる名前や単位で並んでいた
- 収集側の設定が担当者ごとに異なり、サーバーを1台追加するたびに手順を確認し直す必要があった
- パネルは多いものの、朝に確認したいのは「サーバーが動いているか」「ディスクに余裕があるか」の2点だけだった
最も影響が大きかったのは3点目です。指標が多いこと自体は問題ではありません。全員が毎日確認する画面と、障害時に原因を調べる画面を分けていなかったことが問題でした。その結果、ダッシュボードが開かれるのは障害が起きた後になっていました。
Beszelとは何か、どのような仕組みか
Beszelは、MITライセンスで公開されている軽量な監視ツールで、2つのコンポーネントから成ります。
| コンポーネント | 役割 |
|---|---|
| ハブ | PocketBase上に構築されたWebアプリ。ダッシュボードの表示と履歴データの保存を担う |
| エージェント | 監視対象の各サーバーで動作し、指標をハブへ送る |
データはハブ側で保存されるため、PrometheusやInfluxDBのような時系列データベースを別途用意する必要はありません。Beszel公式のセキュリティガイドによると、ハブとエージェントは次のいずれかの方向で接続します。
| 接続方式 | 接続を開始する側 | デフォルトのポート |
|---|---|---|
| SSH | ハブ → エージェント | 45876 |
| WebSocket | エージェント → ハブ | 8090 |
SSH接続はハブの公開鍵のみを受け付け、端末の割り当てや入力の受け付けを行いません。そのため、鍵が漏えいした場合でもエージェント上でコマンドを実行することはできない設計です。ハブから直接到達できない社内ネットワーク内のサーバーでは、エージェントから外向きに接続するWebSocketのほうが、ファイアウォールの設定が容易な場合が多いと考えます。
社内サーバーへのBeszel導入は、どのような手順で行うのか
Beszelの導入に必要なのは、ハブと各サーバーでのDocker Composeだけです。VAONでは次の手順で導入しました。
- ハブを起動する:
henrygd/beszelイメージを使ったdocker-compose.ymlを用意し、ポート8090とデータ用のボリュームを設定します。 - サーバーを追加する:ハブの画面で「Add System」を押すと、公開鍵(
KEY)、トークン(TOKEN)、ハブのURL(HUB_URL)を含むエージェント用のcomposeファイルが生成されます。 - エージェントを起動する:生成されたcomposeファイルを各サーバーで起動します。
/var/run/docker.sockを読み取り専用でマウントすると、コンテナごとのCPU、メモリ、ネットワークも取得できます。 - アラートを設定する:サーバーごとに「どの指標が、どの閾値を、どのくらいの時間超えたら」という形で設定します。
- 通知先を登録する:Settings > Notifications に、Shoutrrr形式のURL(Slack、Discord、Telegram、Teamsなど)を登録します。
バージョン0.12.0からはユニバーサルトークンが使えるようになり、ハブ側で事前にサーバーを登録しなくてもエージェントを接続できます。サーバーの追加は「composeファイルを置いて起動する」だけになりました。小さな変化ですが、手順を毎回確認し直す必要はなくなりました。
運用チームは、毎日どのような画面を見ているのか
Beszelの一覧画面では、1台のサーバーが1行にまとまり、CPU、メモリ、ディスク、GPU、ロードアベレージ、ネットワーク、稼働時間が並びます。使用率が高いセルはバーが黄色になるため、すべての数値を読まなくても注意が必要な行が分かります。なお、スクリーンショット内のプロジェクト名は伏せています。
上のスクリーンショットでは、「Active Alerts」に、開発環境のサーバーでディスク使用率が10分以上80%を超えたというアラートが表示されています。これはサンプルではなく、実際に運用しているアラートのルールです。

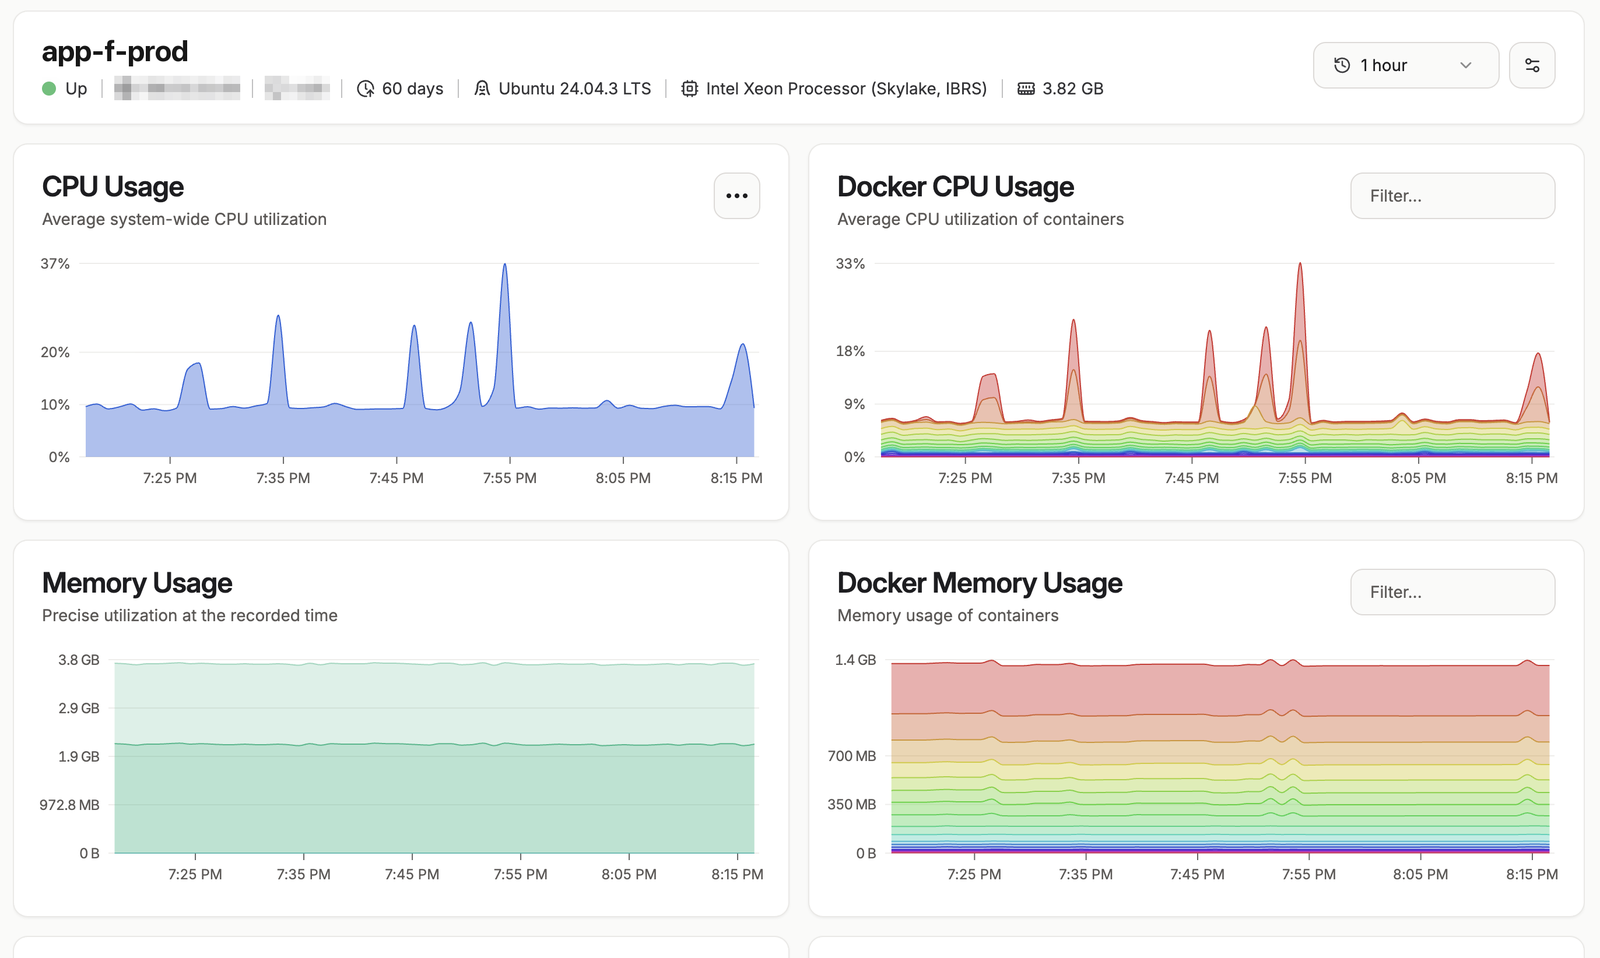
各サーバーの詳細画面には、Dockerコンテナ単位のグラフが最初から表示されます。Grafanaで同様の画面を作る場合は、通常cAdvisorなどの収集コンポーネントを別途導入する必要があります。

このサーバーでは、CPU、帯域、DockerのネットワークI/Oのスパイクがほぼ同じ時刻に発生しています。Dockerのグラフのフィルターを使えば、どのコンテナが原因かを絞り込めます。Beszelだけで根本原因まで特定できるとは限りませんが、次にどこを調べるべきかは判断できます。
BeszelでS.M.A.R.T.を監視するには、何が必要か
S.M.A.R.T.(Self-Monitoring, Analysis and Reporting Technology)は、ディスクが自ら記録する診断情報で、故障の予兆をつかむために使います。VAONが社内サーバーの監視にBeszelを選んだ理由の一つです。クラウドのサーバーであればディスク障害は事業者が対応しますが、社内の物理サーバーでは自分たちで気づき、交換する必要があります。
なお、クラウドのVPSは仮想ディスクを使うため、S.M.A.R.T.の情報は取得できません。この機能が意味を持つのは、物理ディスクを持つサーバーだけです。
Beszel公式のS.M.A.R.T.ガイドによると、必要な準備は次のとおりです。
- エージェントを動かすマシンに
smartmontoolsをインストールする(smartctl7.0以上) - Dockerの場合、エージェントのイメージを
henrygd/beszel-agent:alpineに変更する - ディスクのデバイス(例:
/dev/sda、/dev/nvme0)をコンテナに渡し、SATAにはSYS_RAWIO、NVMeにはSYS_ADMINの権限を付与する - systemdでエージェントを動かす場合は、
[Service]にAmbientCapabilities、CapabilityBoundingSet、DeviceAllowを追加する
デバイスは sda1 のようなパーティションではなく、sda や nvme0 のようにディスク単位で指定します。S.M.A.R.T.のアラートには閾値の設定がなく、Beszelが障害(failure)を検出した時点で自動的に通知されます。ただし、通知先が1つ以上登録されていることが前提です。
BeszelとGrafanaは、どこが違うのか
BeszelとGrafanaは、解決しようとしている課題が異なります。サーバー監視に使う場合の主な違いは次のとおりです。
| 項目 | Beszel | Grafana(Prometheusと併用) |
|---|---|---|
| 構築するコンポーネント | ハブ + エージェント | Grafana + Prometheus + エクスポーター |
| サーバーの追加 | ハブが生成するcomposeファイルを起動 | エクスポーターの導入と収集設定の変更 |
| Dockerコンテナ単位の指標 | 標準で対応 | cAdvisorなどが別途必要 |
| ダッシュボードのカスタマイズ | 固定 | ほぼ自由 |
| 自由なクエリ | なし | PromQL |
| ログ、アプリケーションの指標 | 非対応 | 対応(Loki、アプリのエクスポーター) |
| S.M.A.R.T. | 標準で対応、自動アラート | 専用のエクスポーターが必要 |
Beszelは「サーバーは健全か」という問いに答えるツールです。Grafanaは、設定に時間をかければ、ほぼどんな問いにも答えられます。
Beszelが向いていないのは、どのような場合か
アプリケーションの内部を詳しく見る必要がある場合、Beszelは適していません。具体的には次のとおりです。
- ログを確認できない
- リクエスト数、レイテンシ、キューの長さといったアプリケーションの指標を取得できず、独自の指標も追加できない
- ダッシュボードは固定で、PromQLのような自由なクエリはない
- S.M.A.R.T.のアラート条件は調整できない
アプリケーションの挙動を細かく監視したいプロダクトでは、PrometheusとGrafanaのほうが適していると考えます。VAONでは、サーバーの層はBeszelで監視し、アプリケーションの監視は別の仕組みに任せています。
移行して、何が変わったのか
移行前は、指標が減ることで障害の原因を追いにくくなるのではないかと懸念していました。現時点では、サーバー単位で把握したいことはBeszelの画面で足りています。
最も大きな変化は、ダッシュボードを開く人が増えたことです。一覧画面が1枚だけなので、インフラ担当以外のメンバーも朝に確認し、黄色いバーがあれば担当者に声をかけるようになりました。もう一度最初から設計するなら、どの指標を集めるかより先に、だれが毎朝この画面を開き、黄色を見つけたらだれに伝えるかを決めると思います。
リリース後のシステム監視や運用体制についてお悩みの際は、VAONのシステム開発サービスやDXコンサルティングもご覧ください。現在の構成の確認をご希望の場合は、無料相談からお問い合わせいただけます。